Ground stop du 13 novembre : comment un routeur a cloué au sol tout le trafic aérien américain
16 Nov 2026 | Informatique et Technologie
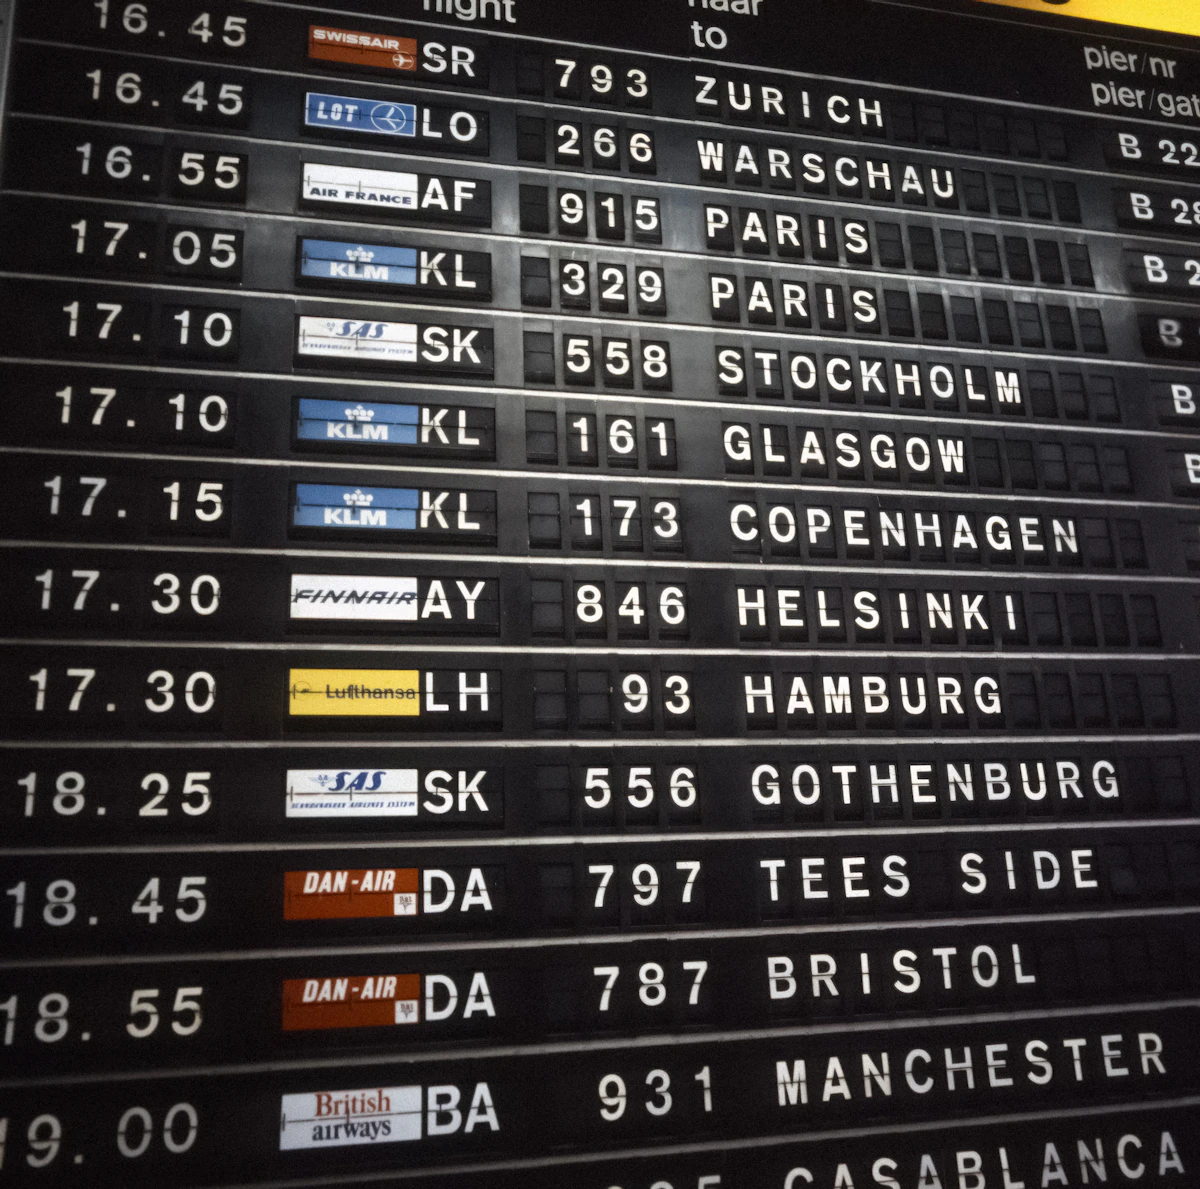
Vendredi 13 novembre 2026, peu avant 16h (heure de New York), l'Administration fédérale de l'aviation américaine (FAA) a ordonné un ground stop national : plus aucun vol ne pouvait décoller vers ou depuis les aéroports américains. Le trafic a repris quatre heures plus tard, mais les annulations se sont comptées en milliers pendant tout le week-end. La cause n'était ni une cyberattaque ni une panne logicielle géante, mais un équipement réseau installé lors de travaux de modernisation.
Les faits
- Vers 15h30 (ET), soit 20h30 au Maroc : la FAA rencontre un problème technique et déclenche l'arrêt des départs par précaution.
- 20h15 (ET) : le système est stabilisé et le trafic reprend progressivement.
- Environ 3 500 avions en vol ont atterri sans incident, selon la FAA.
- Les compagnies ont annulé environ 12 462 vols (plus de 9 000 le vendredi, plus de 5 000 le samedi), même si toutes les annulations ne sont pas directement liées à l'arrêt. Le retour à des horaires normaux était attendu le dimanche soir.
Que s'est-il passé techniquement ?
Selon la FAA, un flot de données excessif a saturé son réseau de télécommunications FTI (FAA Telecommunications Infrastructure), à raison d'environ 1 000 tentatives de connexion toutes les 4 à 5 secondes. Cette avalanche a déstabilisé les équipements et perturbé les communications avec les avions et les flux radar dans 17 des 22 centres de contrôle en route du pays, ainsi que dans certaines installations radar d'approche.
L'enquête initiale pointe deux sites : un site radar à Amarillo (Texas) et un site radio à El Dorado (Arkansas), où de nouveaux routeurs étaient en cours de déploiement par L3Harris, le prestataire réseau de la FAA, dans le cadre du remplacement de liaisons en cuivre par de la fibre optique. Une fois ces deux sites isolés, le réseau s'est stabilisé.
Le secrétaire aux Transports Sean Duffy a évoqué « une erreur du sous-traitant ou un équipement défectueux » ; l'enquête doit encore trancher entre ces deux hypothèses.
Cyberattaque écartée
La Maison Blanche a réuni une cellule d'urgence face au risque cyber, mais les autorités ont rapidement conclu à une cause technique. « Nous ne voyons aucune preuve de quoi que ce soit de malveillant, ni aucune preuve d'un lien avec l'IA », a déclaré l'administrateur de la FAA, Bryan Bedford.
La coïncidence avec la panne mondiale de Microsoft 365, survenue la veille et le jour même, a alimenté les spéculations, mais aucun lien n'a été établi entre les deux incidents.
Les mesures prises
- Les fonctions de diffusion (broadcast) ont été désactivées sur les nouveaux routeurs, et la même correction a été appliquée à une soixantaine d'équipements similaires.
- La FAA va revoir les horaires de maintenance : le remplacement du routeur avait été effectué en pleine journée, et non de nuit, quand le trafic est faible.
- La FAA et L3Harris poursuivent l'enquête sur la cause racine.
Un système vieillissant
Ce n'est pas la première fois : en janvier 2023, la panne du système NOTAM (les avis aux navigants) avait déjà entraîné le premier arrêt national des départs depuis le 11 septembre 2001. Le réseau en cause en 2026 mêle des équipements anciens (liaisons TDM) et des équipements neufs en cours de déploiement. C'est précisément pendant ces périodes de transition que les risques sont les plus élevés.
Les leçons pour les équipes informatiques
On ne gère pas le contrôle aérien, mais les erreurs de ce 13 novembre se retrouvent dans beaucoup de systèmes d'information.
1. Les changements d'infrastructure sont la première cause de panne
Comme chez Microsoft la veille, c'est une modification réseau qui a tout déclenché. Chaque changement d'équipement ou de configuration doit être traité comme un déploiement : préparé, validé, réversible.
2. Choisir le bon créneau
Changer un routeur sur un réseau critique en pleine journée, c'est maximiser l'impact d'une erreur. Planifiez les interventions risquées aux heures creuses, avec l'équipe disponible pour revenir en arrière.
3. Déployer progressivement
Un premier site, une période d'observation, puis les suivants. Un déploiement progressif (comme un canary en logiciel) limite la casse à un seul site si quelque chose tourne mal.
4. Limiter le rayon d'impact
Un seul équipement défectueux a suffi à perturber 17 centres sur 22. Segmenter le réseau, limiter le trafic de diffusion et poser des seuils de protection (rate limiting) empêchent une anomalie locale de devenir une panne nationale. C'est le même principe que les limites de débit dans une application (voir notre checklist de durcissement Laravel).
5. Savoir isoler vite
La FAA a stabilisé le réseau en bloquant deux sites. Encore faut-il savoir rapidement lesquels : supervision, journalisation des changements récents et inventaire à jour font gagner des heures (voir superviser une application en production).
6. La précaution plutôt que le risque
Arrêter tous les départs a coûté cher, mais aucun avion n'a été mis en danger. Dans un incident, savoir passer en mode dégradé de façon volontaire et contrôlée vaut mieux que de laisser le système fonctionner à l'aveugle.
Conclusion
Le ground stop du 13 novembre montre qu'une infrastructure critique peut être mise à genoux sans attaque, par un simple équipement mal configuré ou défectueux installé au mauvais moment. Pour toutes les organisations, la leçon est la même que pour la panne Microsoft : les changements sont le moment le plus dangereux de la vie d'un système, et ils méritent autant de rigueur que la production elle-même.
Sources : FAA (« Nationwide Ground Stop: Questions and Answers »), Al Jazeera (14 et 15/11/2026), CNN (13/11/2026). L'enquête sur la cause racine est toujours en cours.
Commentaires (0)
Aucun commentaire pour le moment.
Laissez un commentaire